Wichtige Erkenntnisse
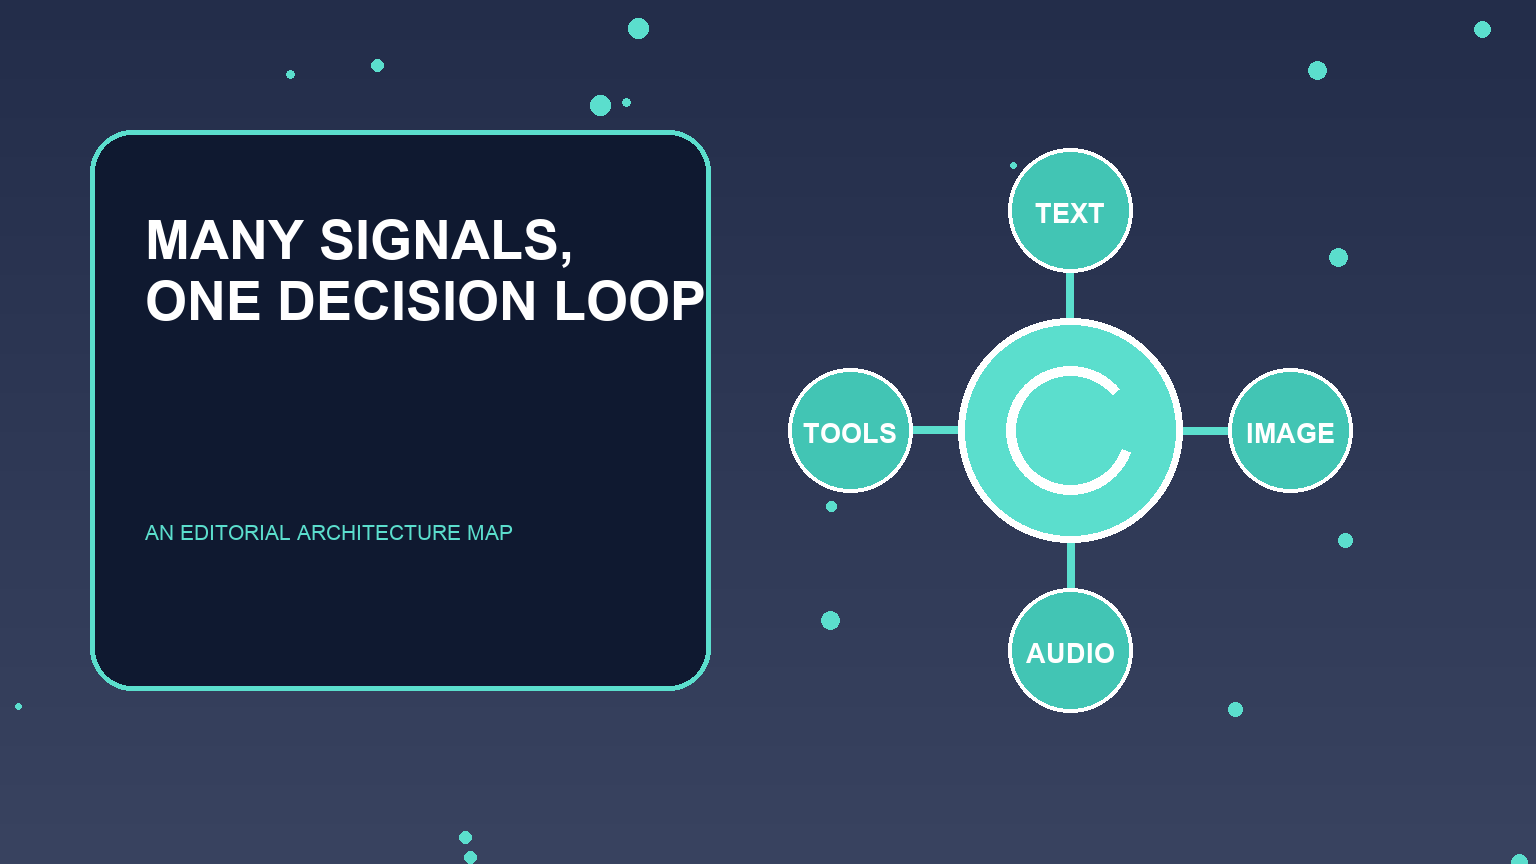
- Das Erstellen von KI-Agenten mit multimodalen Modellen erfordert mehr als nur das Hinzufügen von Bildern zu einem Prompt. Ein zuverlässiges System verfolgt die Quelle und den Zeitpunkt jeder Modalität, wandelt die Wahrnehmung in strukturierte Beobachtungen um, prüft die Unsicherheit und verhindert, dass unvertrauenswürdige Medien direkt Werkzeugaktionen autorisieren.
Das Erstellen von KI-Agenten mit multimodalen Modellen erfordert mehr als nur das Hinzufügen von Bildern zu einem Prompt. Ein zuverlässiges System verfolgt die Quelle und den Zeitpunkt jeder Modalität, wandelt die Wahrnehmung in strukturierte Beobachtungen um, prüft die Unsicherheit und verhindert, dass unvertrauenswürdige Medien direkt Werkzeugaktionen autorisieren.
Modalitäten anhand der Aufgabe auswählen
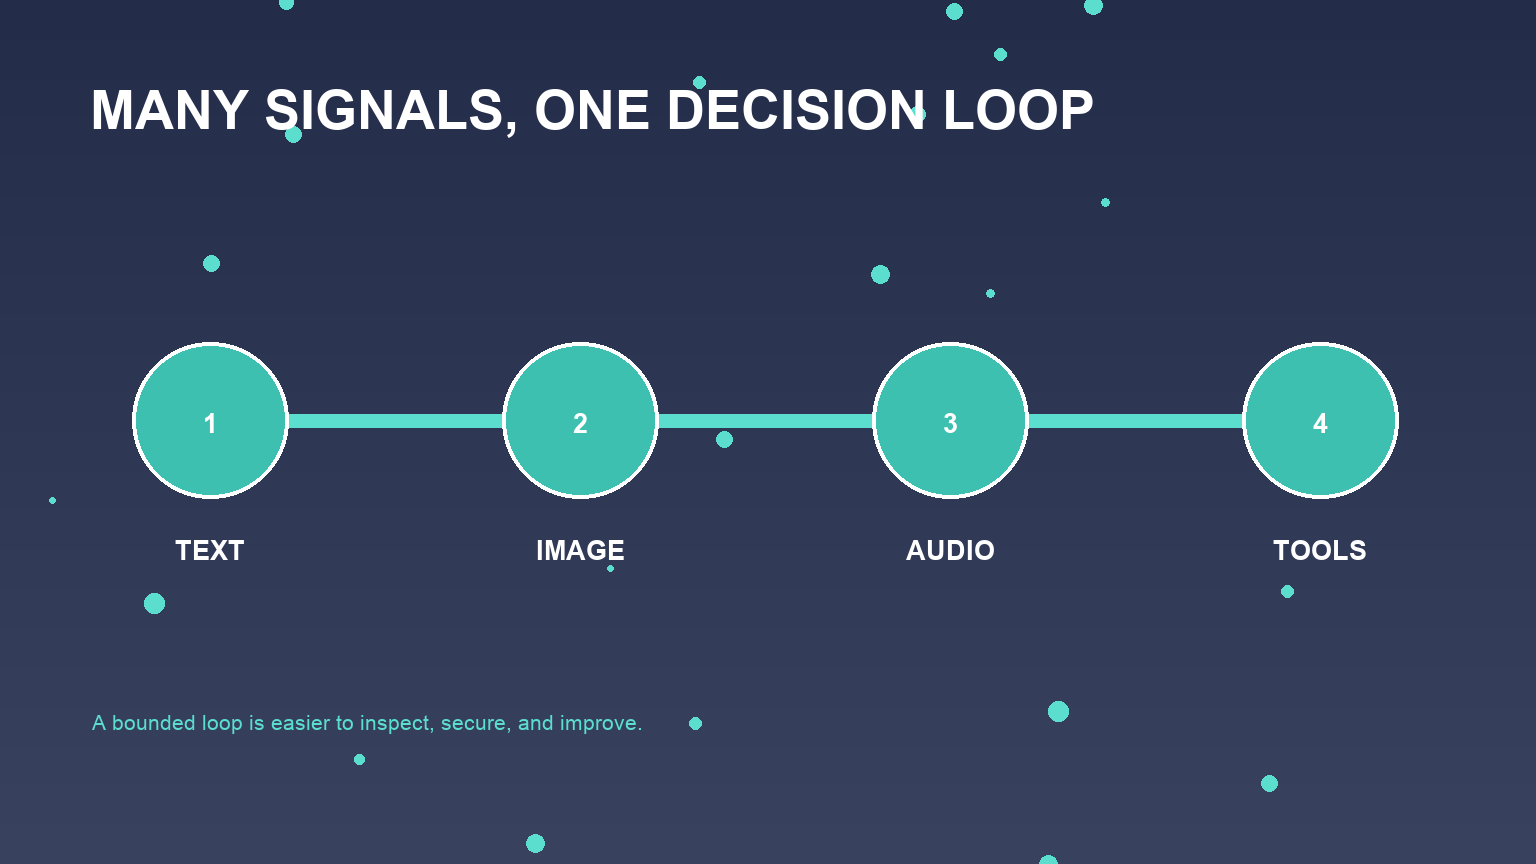
Beginnen Sie mit der Entscheidung, die der Agent unterstützen muss. Bilder helfen bei räumlichen oder visuellen Zuständen, Audio bei Sprache und akustischen Ereignissen, Video bei Veränderungen über die Zeit und Dokumente bei Layout plus Text. Jede zusätzliche Modalität erhöht die Kosten, die Risiken für die Privatsphäre und die Synchronisationsprobleme. Verwenden Sie die kleinste Auswahl, die eine messbare Aufgabe verbessert.
Definieren Sie, was das Modell ableiten darf. Ein Screenshot kann den sichtbaren Schnittstellenzustand zeigen, aber nicht beweisen, wer das Konto besitzt. Ein Kamerabild kann auf ein Objekt hindeuten, aber nicht die Identität, Sicherheit oder Absicht feststellen. Folgenreiche Schlussfolgerungen benötigen stärkere Sensoren, Metadaten oder menschliche Bestätigung.
Eingang, Zeit und Herkunft
Jeder Eingang sollte eine Quelle, Erfassungszeit, Inhaltstyp, Abmessungen oder Dauer, Transformationen und Zugriffsumfang tragen. Bewahren Sie das Original, wenn die Richtlinie es erlaubt, und leiten Sie Vorschaubilder, Transkripte oder Frames als separate Artefakte ab. Hashes und IDs ermöglichen es, eine Schlussfolgerung zurück zu Beweisen zu verfolgen.
Zeit ist wichtig. Ein veralteter Screenshot und eine aktuelle API-Antwort können in Konflikt geraten. Video-Frames können zu spärlich abgetastet werden, um ein Ereignis zu erfassen. Audio-Transkripte können Informationen über Sprecher oder Ton verlieren. Der Agent sollte diese Grenzen offenlegen und vermeiden, Beobachtungen als gleichzeitig zu behandeln.
Wandeln Sie Wahrnehmung in strukturierte Beobachtungen um
Geben Sie keine unbegrenzte visuelle Beschreibung direkt an einen Ausführer weiter. Extrahieren Sie typisierte Beobachtungen wie erkannte Steuerelementbezeichnungen, Begrenzungsregionen, Transkriptabschnitte, Konfidenzbereiche und ungelöste Ambiguitäten. Wenden Sie dann deterministische Regeln an, bevor eine Aktion gewählt wird.
Stimmen Sie visuelle Aktionen auf den aktuellen Zustand ab. Für Browser- oder Desktop-Agenten: erneutes Beobachten nach Navigation und vor einer folgenschweren Klick-Aktion. Koordinatenbasierte Aktionen sind brüchig, wenn sich die Layouts verändern. Verwenden Sie semantische Zugänglichkeitsdaten oder Produkt-APIs, wo verfügbar, und verwenden Sie Pixel nur als unterstützende Beweise, nicht als stille Autorität.
Multimodale Prompt-Injektion und Privatsphäre
Bilder können Anweisungen, QR-Codes, versteckten Text oder irreführende Schnittstellenelemente enthalten. Audio kann Befehle von einem unvertrauenswürdigen Sprecher enthalten. Dokumente können feindlichen Text in Kopfzeilen oder Hintergründen platzieren. Behandeln Sie erkannte Inhalte als Daten mit Herkunft. Sie können keine Richtlinie überschreiben oder Werkzeugzugriff gewähren.
Multimodale Daten sind oft sensibel. Gesichter, Stimmen, Bildschirme, Standorte und Dokumente können persönliche oder vertrauliche Informationen enthüllen. Begrenzen Sie die Erfassung, schneiden Sie Inhalte vor der Modellverarbeitung zu oder schwärzen Sie sie, beschränken Sie die Speicherung und holen Sie die entsprechende Zustimmung ein. Halten Sie Geheimnisse und unzusammenhängende Bildschirmbereiche aus dem Kontext fern.
Verifikation und Fallback-Design
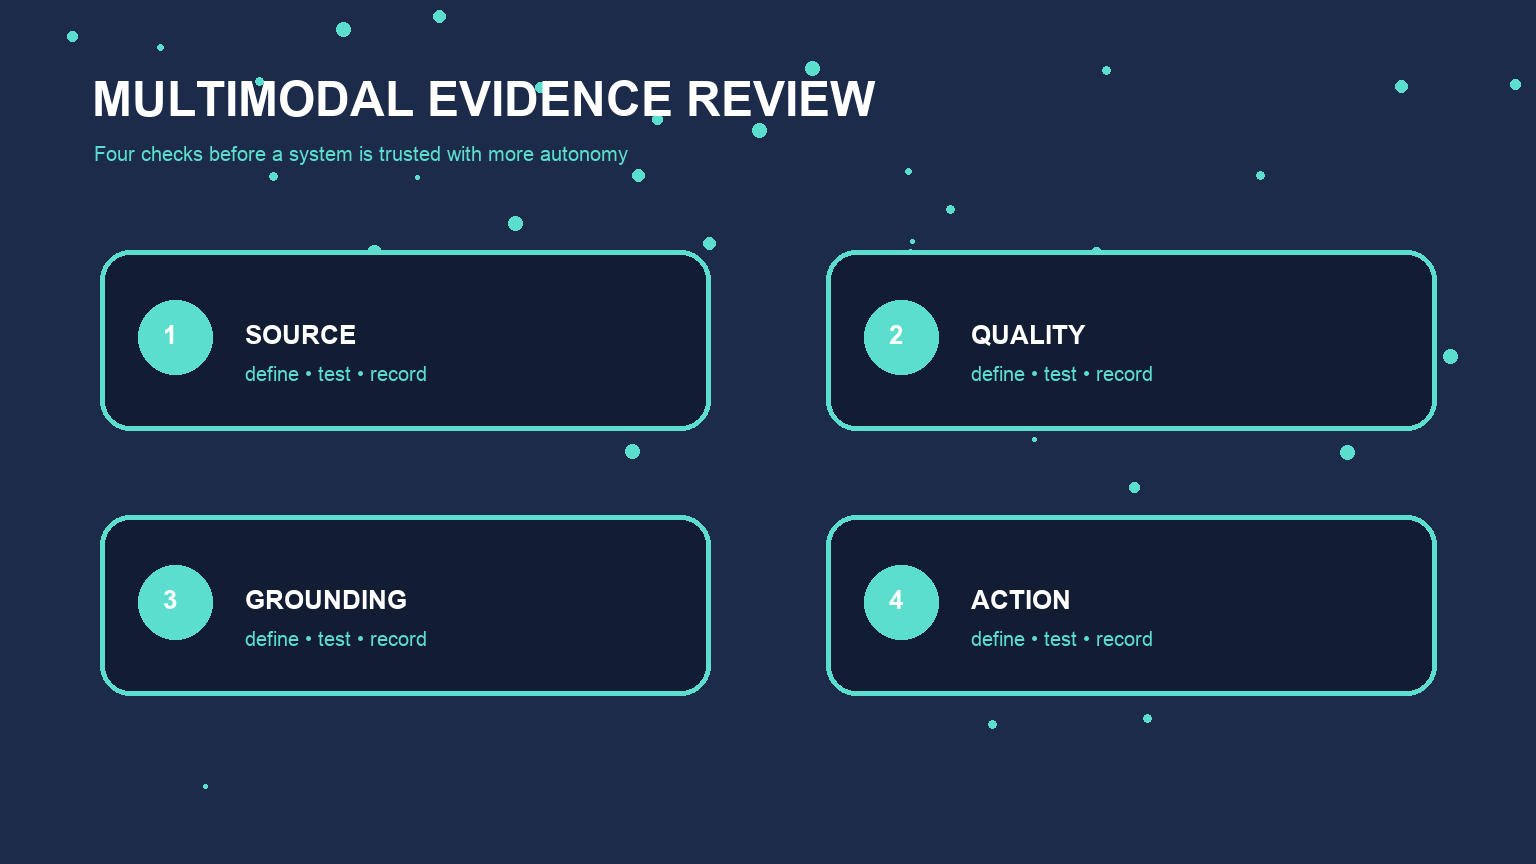
Verwenden Sie Kreuzverifikationen, die dem Risiko entsprechen. OCR kann eine sichtbare Beschriftung verifizieren; eine API kann den Transaktionszustand bestätigen; ein zweites Bild kann zeigen, dass eine Änderung bestehen blieb. Übereinstimmung zwischen Modalitäten ist nützlich, aber kein Beweis, wenn beide aus dem gleichen manipulierten Quellmaterial stammen. Bei unklaren oder sicherheitskritischen Fällen stoppen und eine Person fragen.
Der Fallback sollte die Funktion bei geringerer Autonomie erhalten. Wenn die Bildverarbeitung fehlschlägt, ein klareres Bild anfordern oder zu strukturierter Eingabe wechseln. Wenn die Spracherkennung unsicher ist, das Transkript anzeigen, um es zu bestätigen. Wenn ein Video die Grenzen überschreitet, benutzen Sie vom Nutzer genehmigte Abschnitte anstelle davon, Inhalt still zu verwerfen.
Bewerten Sie realistische multimodale Ausfälle
Erstellen Sie einen Datensatz mit Unschärfe, Blendung, Verdeckung, Akzenten, Hintergrundgeräuschen, Layout-Änderungen, veralteten Bildern, widersprüchlichen Untertiteln, injiziertem Text und fehlenden Metadaten. Bewerten Sie die Wahrnehmung getrennt von Entscheidung und Ausführung, damit Teams wissen, wo Fehler beginnen. Messen Sie auch Latenz, Bandbreite, Kosten und Umgang mit Privatsphäre.
Wiederholen Sie vollständige Spuren nach Änderungen der Modelle oder Vorverarbeitung. Überwachen Sie modalitätsspezifische Ausfallraten und menschliche Korrekturzeit. Multimodale Agenten können mit reicheren Umgebungen interagieren, aber sichere Leistung kommt aus Herkunft, begrenzten Aktionen und Verifikation – nicht aus der Annahme, dass Sehen und Hören Verständnis implizieren.
Implementierungs-Checkliste
Erstellen Sie ein Modalitäten-Datenblatt für jede Eingabe: Quelle, Erfassungszeit, Transformationen, erwartete Qualität, sensibler Inhalt, Speicherung und bekannte Blindstellen. Testen Sie die Wahrnehmung getrennt von der Aktionsrichtlinie. Fügen Sie Fälle mit veralteten Screenshots, verstecktem Text, verrauschtem Audio, fehlenden Frames, Layout-Shifts und widersprüchlichen API-Zuständen hinzu. Verlangen Sie, dass der Agent das zugrunde liegende Artefakt hinter jeder Beobachtung zitiert und bei unzureichender Sicherheit Klärung anfordert. Überprüfen Sie, ob jede erfasste Modalität notwendig ist; das Entfernen einer Eingabe kann die Privatsphäre, Latenz und Zuverlässigkeit verbessern.
FAQs
Was ist ein multimodaler KI-Agent?
Es ist ein Agent, der zwei oder mehr Eingabe- oder Ausgabemodalitäten – wie Text, Bilder, Audio, Video oder Sensordaten – während der Planung und Nutzung von Tools verwendet.
Kann ein Bild einen Agenten anweisen, eine Aktion auszuführen?
Bildtext sollte als unvertrauenswürdige Daten betrachtet werden. Er kann in einen Vorschlag einfließen, darf aber weder Richtlinien außer Kraft setzen noch Berechtigungen erteilen oder einen folgenreichen Tool-Aufruf autorisieren.
Wie sollte multimodales Beweismaterial gespeichert werden?
Verfolgen Sie Quelle, Erfassungszeit, Transformationen, Zugriffsrechte, Artefakt-IDs und Hashwerte, wo angebracht, damit Beobachtungen nachvollziehbar bleiben.
Wie testet man einen multimodalen Agenten?
Testen Sie Wahrnehmung, Entscheidung und Ausführung getrennt, indem Sie realistische Unschärfe, Rauschen, Verdeckung, Layout-Shifts, veraltete Beweise, widersprüchliche Modalitäten und Prompt-Injektion verwenden.