重要なポイント
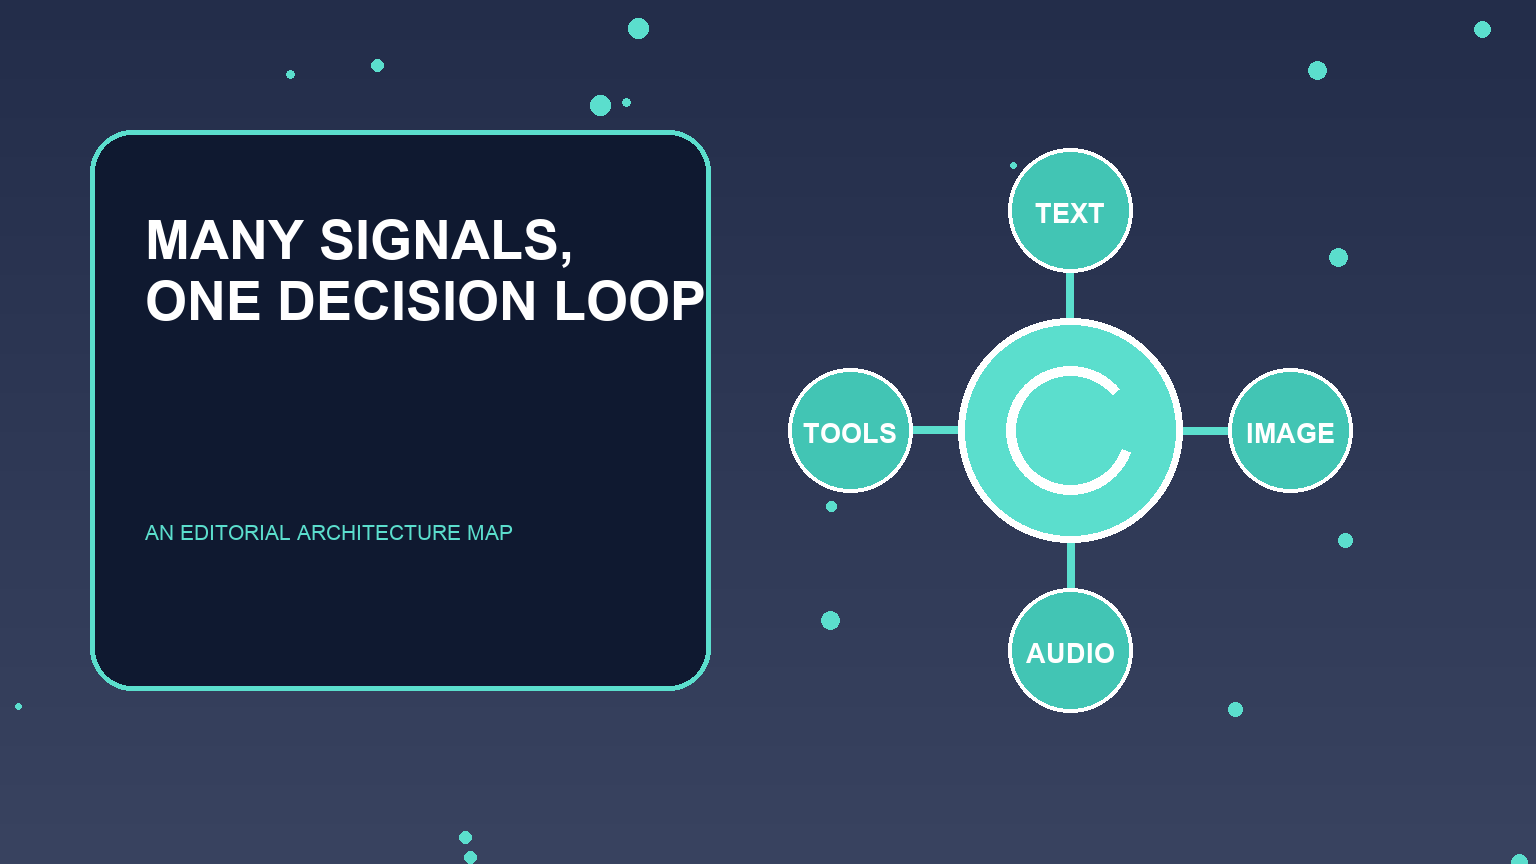
- マルチモーダルモデルでAIエージェントを構築する際、プロンプトに画像を加えるだけでは不十分です。信頼できるシステムは、各モダリティの情報源と時刻を記録し、認識結果を構造化された観測情報に変換して不確実性を確認し、信頼できないメディアがツールの実行を直接許可しないようにします。
マルチモーダルモデルでAIエージェントを構築する際、プロンプトに画像を加えるだけでは不十分です。信頼できるシステムは、各モダリティの情報源と時刻を記録し、認識結果を構造化された観測情報に変換して不確実性を確認し、信頼できないメディアがツールの実行を直接許可しないようにします。
タスクに応じてモダリティを選ぶ
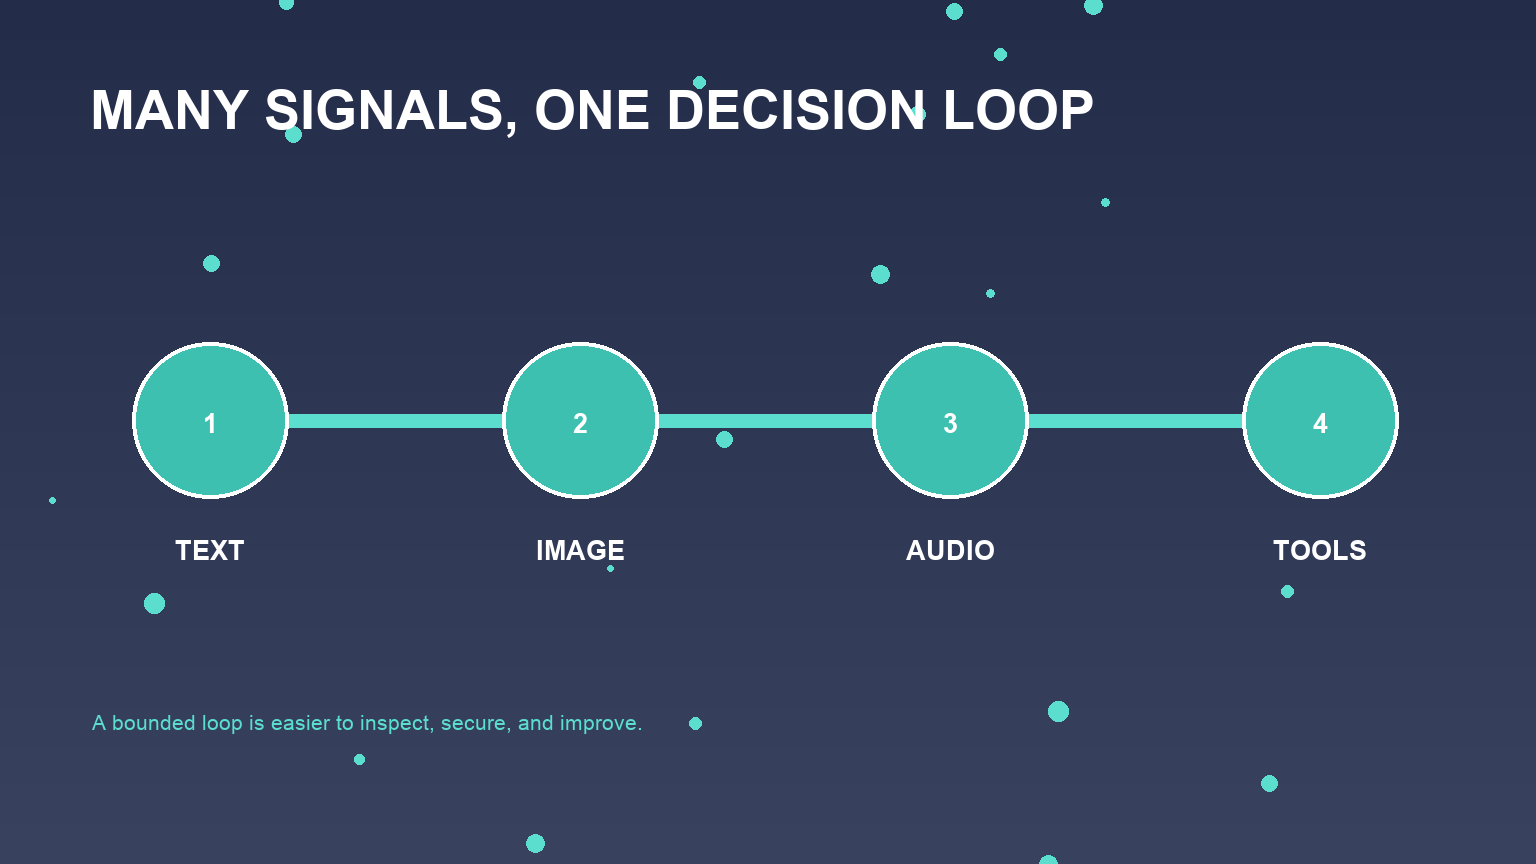
まず、エージェントが支援する判断を明確にします。画像は空間や視覚の状態、音声は発話や音響イベント、動画は時間経過による変化、文書はレイアウトとテキストの把握に役立ちます。すべてのモダリティを追加すると、コストやプライバシー上のリスク、同期の問題が増えます。測定可能なタスクを改善するために必要な最小限の組み合わせを使いましょう。
モデルが何を推論してよいかを定義します。スクリーンショットから画面に表示された状態は分かっても、アカウントの所有者までは証明できません。カメラ画像から物体を推測できても、その正体や安全性、意図を特定できるとは限りません。影響の大きい判断には、より確かなセンサー情報やメタデータ、人による確認が必要です。
取り込み、時刻、来歴
各入力には、情報源、取得時刻、コンテンツの種類、寸法または長さ、適用した変換、アクセス範囲を記録します。ポリシー上可能な場合は元データを保持し、そこから作成したサムネイル、文字起こし、フレームは別の成果物として保存します。ハッシュとIDを使えば、判断の根拠となった証拠までたどれます。
時刻は重要です。古いスクリーンショットと最新のAPI応答が食い違うことがあります。動画のフレームをまばらに抽出すると、イベントを捉え損ねる場合があります。音声の文字起こしでは、話者や口調の情報が失われることがあります。エージェントはこうした限界を明示し、別々の時刻の観測を同時に起きたかのように統合しないようにします。
認識結果を構造化された観測情報に変換する
範囲が定まっていない視覚的な説明を、そのまま実行機能に渡さないでください。検出した操作ラベルや領域、文字起こしの区間、信頼度の範囲、未解決の曖昧さなど、型のある観測情報を抽出します。その後、決定的なルールを適用してからアクションを選びます。
視覚に基づくアクションは、現在の状態に照らして判断します。ブラウザやデスクトップを操作するエージェントでは、画面遷移後と重要なクリックの直前に状態を再確認します。レイアウトが変わると、座標に依存した操作は失敗しやすくなります。利用できる場合は、意味情報を含むアクセシビリティデータや製品APIを優先し、ピクセル画像は補助的な証拠として使います。暗黙の権威として扱わないでください。
マルチモーダルなプロンプトインジェクションとプライバシー
画像には指示やQRコード、隠しテキスト、誤解を招くUI要素が含まれることがあります。音声には信頼できない話者からの命令が含まれる場合があります。文書ではヘッダーや背景に悪意あるテキストが置かれていることもあります。認識した内容は、来歴を伴うデータとして扱ってください。ポリシーを上書きしたり、ツールへのアクセスを許可したりすることはできません。
マルチモーダルデータは機微な情報を含むことがよくあります。顔や声、画面、位置、文書から個人情報や機密情報が分かる場合があります。取得する情報を最小限にし、モデルで処理する前に切り抜きやマスキングを行い、保存期間を制限して適切な同意を得てください。秘密情報や無関係な画面領域はコンテキストに含めないでください。
検証とフォールバックの設計
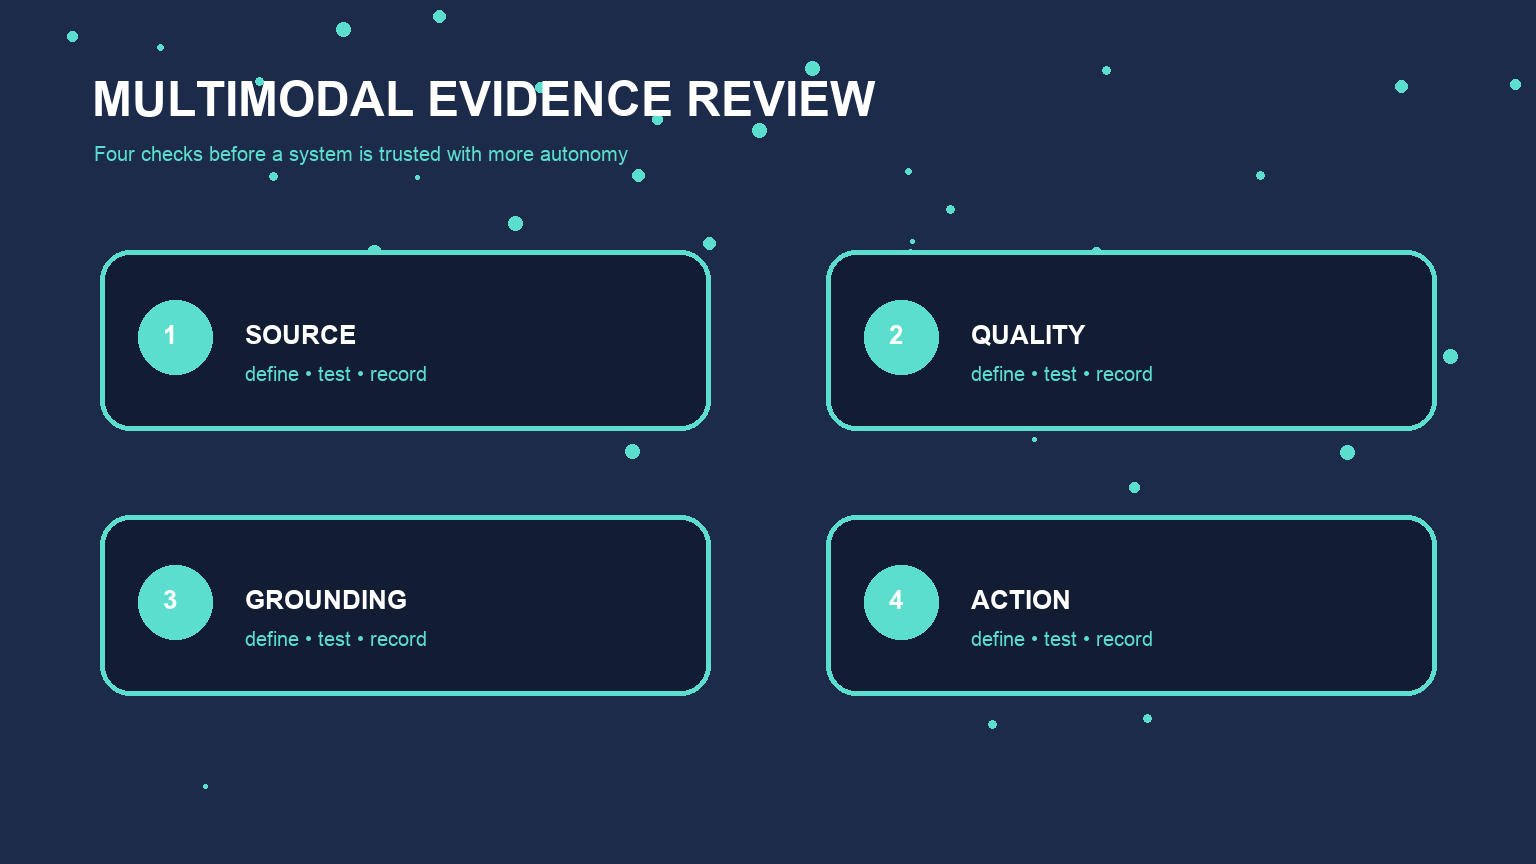
リスクに応じた照合を行います。OCRで画面上のラベルを確認し、APIで取引状態を確かめ、別のフレームで変更が維持されたかを確認できます。複数のモダリティが一致しても、同じ改ざんされた情報源に由来する場合は証明になりません。曖昧なケースや安全性が重要なケースでは、処理を止めて人に確認します。
フォールバックでは、自律性を下げても機能を維持します。画像認識に失敗したら、より鮮明な画像を求めるか、構造化入力に切り替えます。音声の文字起こしに確信が持てない場合は、内容を表示して確認を求めます。動画が制限を超えた場合は、内容を黙って捨てず、ユーザーが承認した区間を選びます。
現実的なマルチモーダルの失敗を評価する
ぼけ、反射、遮蔽、アクセント、背景ノイズ、レイアウト変更、古いフレーム、矛盾するキャプション、注入されたテキスト、欠落したメタデータを含むデータセットを作成します。認識、判断、実行を分けて評価し、エラーの発生箇所を把握できるようにします。遅延、帯域幅、コスト、プライバシーの取り扱いも測定します。
モデルや前処理を変更した後は、完全なトレースを再生します。モダリティごとの失敗率と、人による修正時間を監視します。マルチモーダルエージェントは豊かな環境とやり取りできますが、安全な動作を支えるのは情報の来歴、制限されたアクション、検証です。見聞きできるからといって理解していると仮定することではありません。
実装ワークシート
入力ごとに、情報源、取得時刻、変換内容、想定品質、機微情報、保存期間、既知の死角を記載したモダリティデータシートを作成します。認識とアクションポリシーは分けてテストします。古いスクリーンショットや隠しテキスト、ノイズの多い音声、欠落フレーム、レイアウト変更、API状態との食い違いを含むケースを追加します。各観測の根拠となる成果物をエージェントに示させ、確信度が不十分な場合は確認を求めさせます。取得した各モダリティが本当に必要かも見直してください。入力を減らせば、プライバシー、遅延、信頼性が改善することがあります。
よくある質問
マルチモーダルAIエージェントとは何ですか?
テキスト、画像、音声、動画、センサーデータなど、二つ以上の入力または出力モダリティを使って計画を立て、ツールを利用するエージェントです。
画像の内容によってエージェントにアクションを指示できますか?
画像内のテキストは信頼できないデータとして扱います。提案の参考にはできますが、ポリシーの上書きや権限の付与、重大な結果を伴うツール呼び出しの許可には使えません。
マルチモーダルな証拠はどのように保存すべきですか?
観測を追跡できるよう、情報源、取得時刻、変換内容、アクセス範囲、成果物ID、必要に応じてハッシュを記録します。
マルチモーダルエージェントはどのようにテストしますか?
現実的なぼけやノイズ、遮蔽、レイアウトのずれ、古い証拠、モダリティ間の矛盾、プロンプトインジェクションを用いて、認識、判断、実行を個別にテストします。