Principais pontos
- Criar agentes de IA com modelos multimodais exige mais do que acrescentar imagens a um prompt. Um sistema confiável registra a origem e o horário de cada modalidade, transforma a percepção em observações estruturadas, verifica a incerteza e impede que mídias não confiáveis autorizem diretamente ações de ferramentas.
Criar agentes de IA com modelos multimodais exige mais do que acrescentar imagens a um prompt. Um sistema confiável registra a origem e o horário de cada modalidade, transforma a percepção em observações estruturadas, verifica a incerteza e impede que mídias não confiáveis autorizem diretamente ações de ferramentas.
Escolha as modalidades de acordo com a tarefa
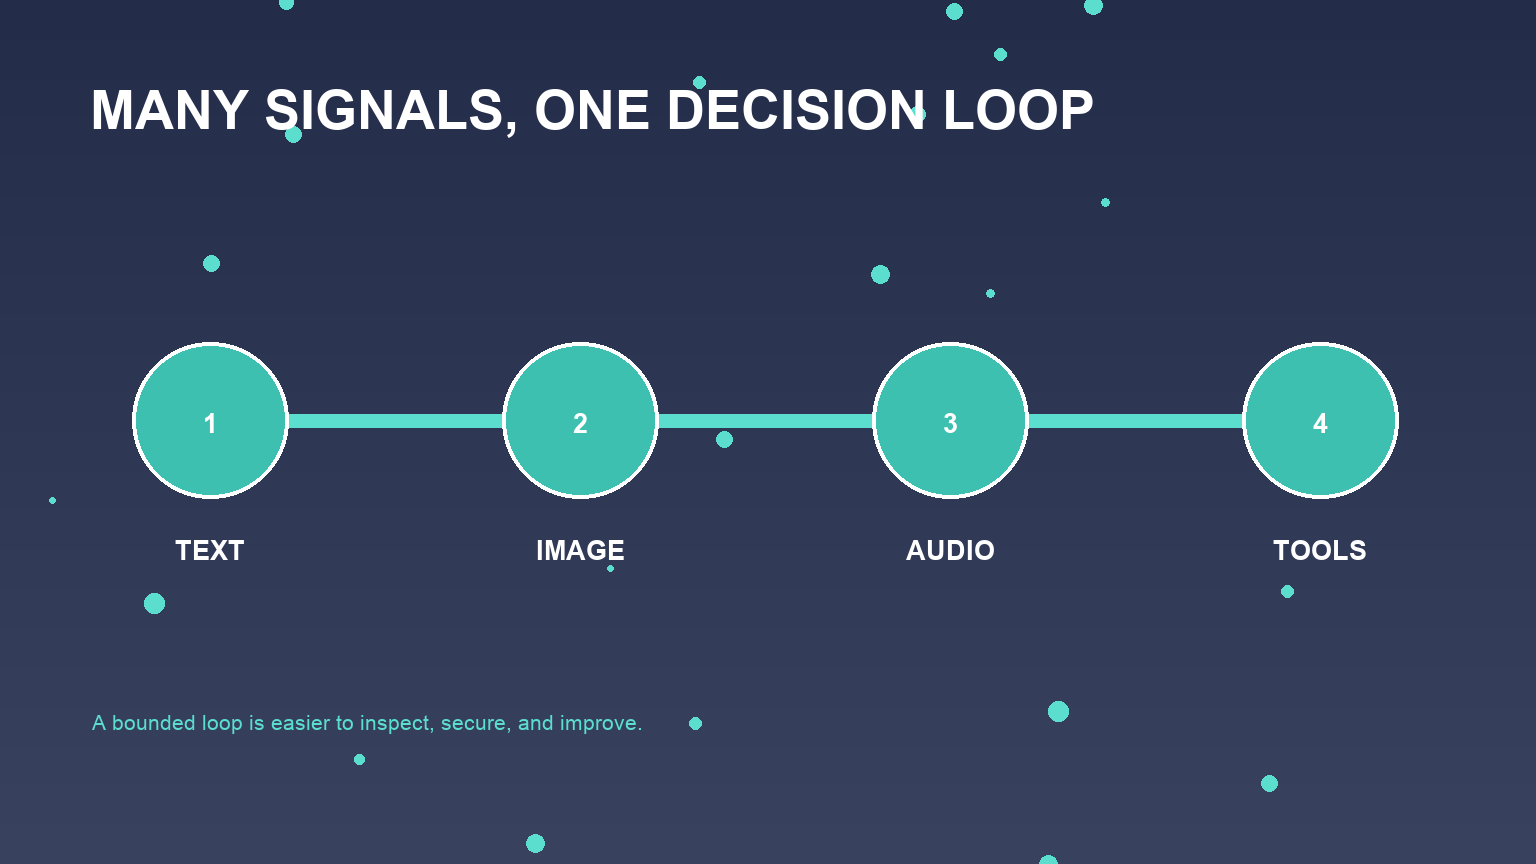
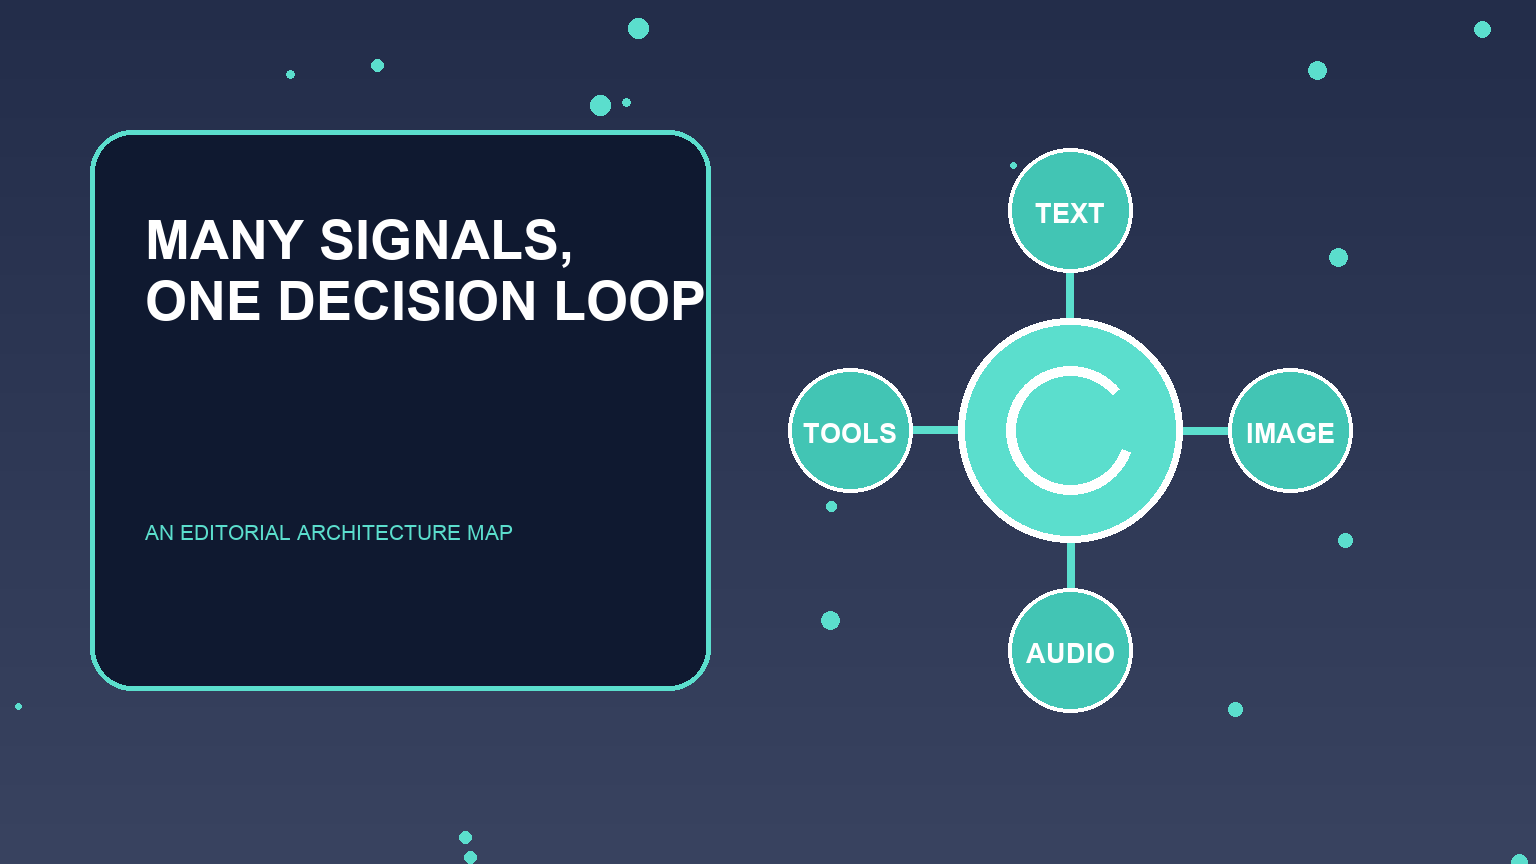
Comece pela decisão que o agente precisa apoiar. Imagens ajudam a identificar estados espaciais ou visuais; o áudio, a fala e os eventos acústicos; o vídeo, as mudanças ao longo do tempo; e os documentos, a disposição visual e o texto. Incluir todas as modalidades aumenta os custos, a exposição de dados pessoais e os problemas de sincronização. Use o conjunto mínimo que melhore uma tarefa mensurável.
Defina o que o modelo pode inferir. Uma captura de tela pode mostrar o estado visível de uma interface, mas não provar quem é o titular da conta. Um quadro de câmera pode indicar a presença de um objeto, mas talvez não determine sua identidade, segurança ou intenção. Conclusões de alto impacto exigem sensores mais confiáveis, metadados ou confirmação humana.
Ingestão, horário e origem dos dados
Cada entrada deve registrar a origem, o horário da captura, o tipo de conteúdo, as dimensões ou a duração, as transformações aplicadas e o escopo de acesso. Preserve o original quando a política permitir e salve miniaturas, transcrições ou quadros derivados como artefatos separados. Hashes e IDs permitem rastrear cada conclusão até as evidências que a sustentam.
O tempo importa. Uma captura de tela desatualizada pode entrar em conflito com uma resposta atual da API. Se poucos quadros forem extraídos de um vídeo, um evento pode passar despercebido. Transcrições de áudio podem perder informações sobre quem fala ou sobre o tom de voz. O agente deve explicitar esses limites e não combinar observações como se fossem simultâneas.
Transforme a percepção em observações estruturadas
Não envie uma descrição visual sem limites diretamente ao executor. Extraia observações tipadas, como rótulos de controles detectados, regiões delimitadas, trechos de transcrição, intervalos de confiança e ambiguidades não resolvidas. Depois, aplique regras determinísticas antes de escolher uma ação.
Fundamente as ações visuais no estado atual. Em agentes de navegador ou desktop, observe novamente após cada navegação e antes de um clique importante. Ações baseadas em coordenadas são frágeis quando o layout muda. Prefira dados semânticos de acessibilidade ou APIs do produto quando disponíveis, usando os pixels como evidência complementar, e não como autoridade implícita.
Injeção de prompts multimodais e privacidade
Imagens podem conter instruções, códigos QR, texto oculto ou elementos enganosos de interface. Áudios podem incluir comandos de uma pessoa não confiável. Documentos podem esconder texto malicioso em cabeçalhos ou no fundo. Trate o conteúdo reconhecido como dado com origem identificável. Ele não pode substituir políticas nem conceder acesso a ferramentas.
Dados multimodais costumam ser sensíveis. Rostos, vozes, telas, locais e documentos podem revelar informações pessoais ou confidenciais. Reduza a captura ao mínimo, recorte ou oculte dados antes do processamento pelo modelo, limite o período de retenção e obtenha o consentimento adequado. Mantenha segredos e áreas irrelevantes da tela fora do contexto.
Projeto de verificação e alternativas de contingência
Faça verificações cruzadas de acordo com o risco. O OCR pode confirmar um rótulo visível; uma API pode confirmar o estado de uma transação; um segundo quadro pode mostrar que uma alteração persistiu. A concordância entre modalidades é útil, mas não é prova quando ambas derivam da mesma fonte manipulada. Em casos ambíguos ou críticos para a segurança, pare e consulte uma pessoa.
A alternativa de contingência deve preservar a função com menor autonomia. Se a visão falhar, solicite uma imagem mais nítida ou use uma entrada estruturada. Se a transcrição de áudio for incerta, mostre-a para confirmação. Se um vídeo exceder os limites, selecione trechos aprovados pelo usuário em vez de descartar conteúdo sem avisar.
Avalie falhas multimodais realistas
Monte um conjunto de dados com desfoque, reflexos, oclusões, sotaques, ruído de fundo, mudanças de layout, quadros desatualizados, legendas conflitantes, texto injetado e metadados ausentes. Avalie a percepção separadamente da decisão e da execução para identificar onde os erros começam. Meça também latência, largura de banda, custos e tratamento de dados privados.
Reproduza os rastros completos depois de alterar o modelo ou o pré-processamento. Monitore as taxas de falha de cada modalidade e o tempo gasto em correções humanas. Agentes multimodais podem interagir com ambientes mais ricos, mas a operação segura depende da origem dos dados, de ações limitadas e de verificação — não da suposição de que ver e ouvir significa compreender.
Folha de trabalho de implementação
Crie uma ficha para cada modalidade de entrada, registrando origem, horário da captura, transformações, qualidade esperada, conteúdo sensível, retenção e pontos cegos conhecidos. Teste a percepção separadamente da política de ação. Inclua casos com capturas desatualizadas, texto oculto, áudio ruidoso, quadros ausentes, mudanças de layout e estados de API conflitantes. Exija que o agente cite o artefato que sustenta cada observação e peça esclarecimentos quando a confiança for insuficiente. Verifique se todas as modalidades capturadas são necessárias: remover uma entrada pode melhorar a privacidade, a latência e a confiabilidade.
Perguntas Frequentes
O que é um agente de IA multimodal?
É um agente que usa duas ou mais modalidades de entrada ou saída — como texto, imagens, áudio, vídeo ou dados de sensores — para planejar e usar ferramentas.
Uma imagem pode instruir um agente a agir?
O texto presente em uma imagem deve ser tratado como dado não confiável. Ele pode servir de referência para uma proposta, mas não pode substituir políticas, conceder permissões nem autorizar chamadas de ferramentas com consequências importantes.
Como armazenar evidências multimodais?
Registre a origem, o horário da captura, as transformações, o escopo de acesso, os IDs dos artefatos e, quando apropriado, os hashes, para que as observações possam ser rastreadas.
Como testar um agente multimodal?
Teste percepção, decisão e execução separadamente, usando casos realistas de desfoque, ruído, oclusão, mudanças de layout, evidências desatualizadas, modalidades conflitantes e injeção de prompts.